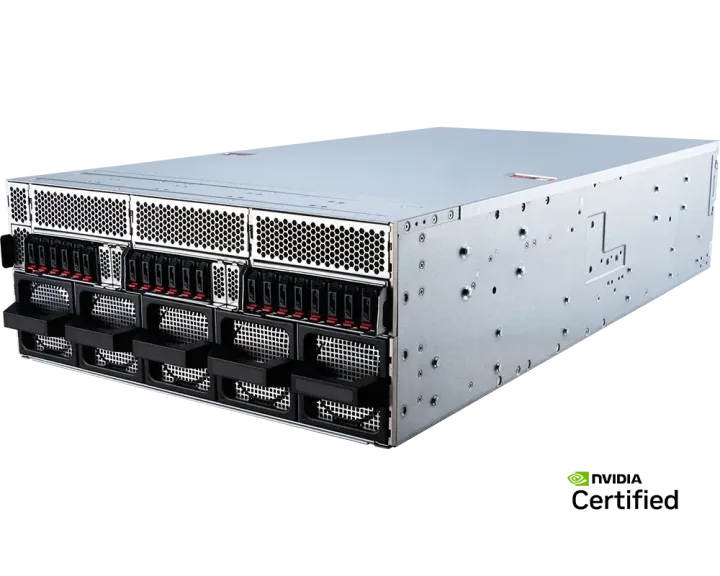
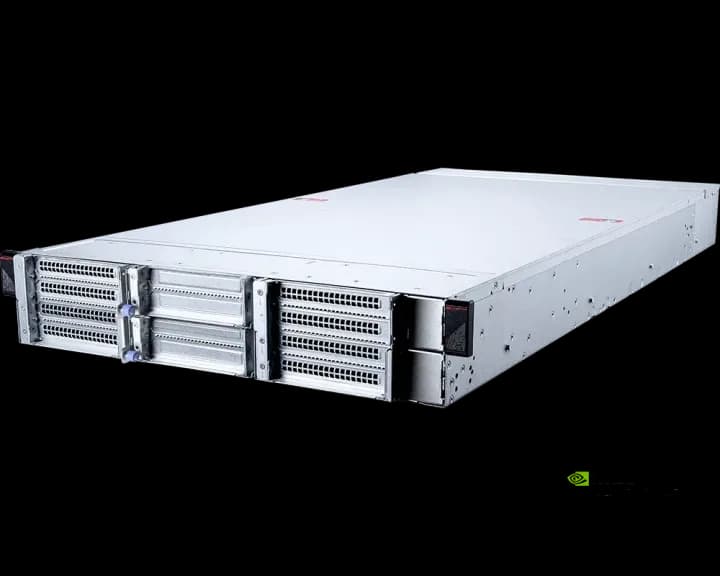
MSI CG290-S3063
S3063G290RAU4
4x PCIe accelerators / 2U / single socket
推理与训练是两类不同的采购,按训练的思路采购推理设备,是超支的常见原因。训练节点的规格是为一项会结束的任务设定的;而推理机型需要全年每小时持续运行,因此决定选型的指标是每瓦吞吐量,以及中位时段机器的实际利用率,而非峰值算力。
因此,合理选型就是这项工作的全部内容。CG290 为单路 2U 机型,最多支持四块加速卡,适合以中等并发量服务单一模型,但并不适合作为后续扩容的起点。CG480 为 4U 机型,提供最多十三个 PCIe 5.0 x16 插槽,可支持八块加速卡,适合将多个模型整合至同一台设备,或用于后续规模会增长的推理层。应从模型规模与并发需求出发,再选择机箱。
这些均为 MGX 系统,因此加速卡属于可选项而非固定配置。当单卡显存容量决定可承载的模型规模时选择 H200 NVL;当每单位成本的吞吐量比容量更重要时,则选择 RTX PRO 6000 Blackwell 服务器版。采用 PCIe 而非 SXM 是一项权衡:GPU 间互联带宽低于 SXM 节点,但功耗与场地负担仅为其一小部分,而对推理场景而言,这通常是权衡中更划算的一侧。
有两项细节决定最终配置。存储取决于机箱选择:Intel 版 CG480 提供二十个前置 E1.S NVMe 盘位,EPYC 版提供八个 U.2 盘位并具备单路十二条内存通道,两者孰轻孰重,取决于工作集是存放在本机还是网络上。此外,CG481 是内置八个 400G QSFP 端口(基于 ConnectX-8)的 CG480 版本,代价是减少四个扩展插槽。当部署从第一天起就是多节点架构时,这一取舍是值得的;若仅为单台设备,则并不值得。
2U 机型支持四块加速卡,4U 机型支持八块,依据模型规模与并发量选择,而非直接选用系列中的顶配机型。
MGX 架构可搭载 H200 NVL(当显存容量决定模型规模时),或 RTX PRO 6000 Blackwell(当单位成本吞吐量更为关键时)。
内置八个 400G 端口需要占用四个扩展插槽。若从第一天起即为多节点部署则值得,若仅为单台设备则不值得。